Schreiben mit eigener Stimme · ca. 5 Min.
Mit KI besser schreiben: Ein Ablauf für klare Texte
Ein einfacher Schreibablauf mit KI: Fakten vorbereiten, einen Entwurf verbessern und den eigenen Ton bewahren. Inklusive kopierbarer Beispielanweisung.
In den News / Modell-Release
Grok 4.7 ist seit dem 21. September 2026 über die xAI-API, Cursor und Grok Build verfügbar. In der API kostet es wie Grok 4.6 2 USD pro Million Eingabe- und 6 USD pro Million Ausgabe-Token. Laut Anbieter steigt der Coding-Wert in CursorBench 4.0 von 40,4 auf 46,3 Prozent. Für unseren Alltag mit X-Posts und Bildern bleibt entscheidend, ob bessere Ergebnisse entstehen – das haben wir mit 4.7 noch nicht getestet.
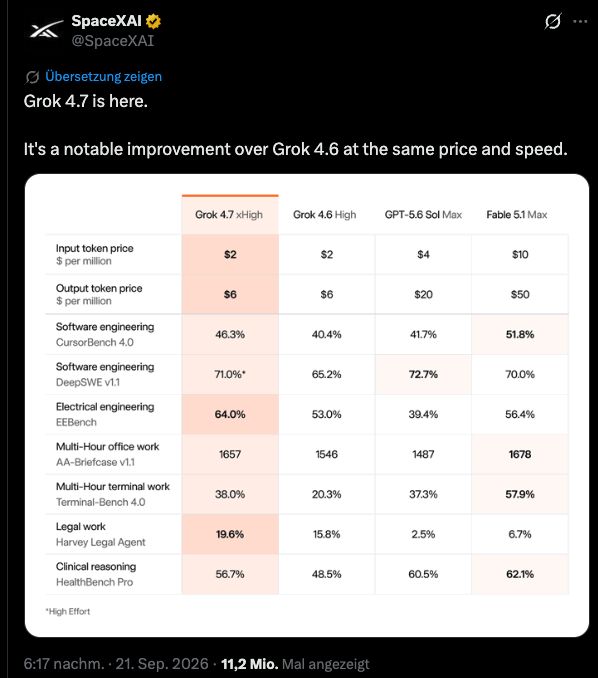
SpaceXAI kündigt Grok 4.7 auf X mit einer Vergleichsgrafik an. Beim Coding-Test CursorBench steigt der Wert von 40,4 auf 46,3 Prozent, beim Terminal-Bench laut X-Grafik von 20,3 auf 38,0 Prozent. Die Tabelle auf der Release-Seite nennt für Terminal-Bench 37,6 Prozent (Stand: 29.09.2026). Das sind 5,9 beziehungsweise gut 17 Prozentpunkte mehr. Die Tabelle zeigt zugleich: Je nach Aufgabe liegen auch andere Modelle vorn.
Das sind Herstellerangaben, kein eigener Test. Grok 4.7 läuft hier meist mit xhigh, der Vorgänger mit high; bei DeepSWE kennzeichnet das Sternchen high für 4.7. Rechenaufwand und eingesetzte Agenten-Software beeinflussen die Ergebnisse. Mehr Punkte belegen weder bessere Bilder noch mehr Reichweite auf X.
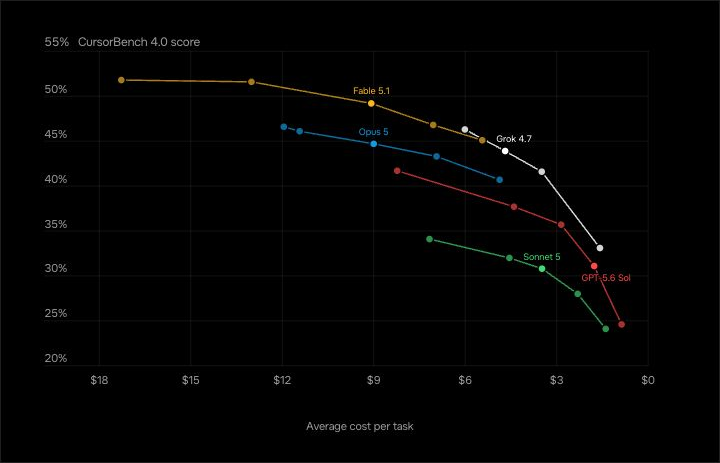
Die Grafik des Anbieters stellt den CursorBench-Wert den durchschnittlichen Kosten je Aufgabe gegenüber. Oben heißt: höherer Testwert. Rechts heißt hier: günstiger, weil die Dollar-Achse nach rechts abnimmt. Die Prozentachse startet bei 20 %; Abstände wirken dadurch größer als auf einer Skala ab null. Ein Modell kann günstig sein, ohne den höchsten Wert zu erreichen.
Die Dokumentation nennt die xAI-API, Cursor und Grok Build als Zugänge, dazu die Modell-Gateways OpenRouter, Vercel und Cloudflare. Das Kontextfenster umfasst 500.000 Token, also die Textbausteine, mit denen das Modell arbeitet. Eine Freischaltung in jedem Grok-Chat-Tarif folgt daraus nicht.
In der regulären API kosten eine Million Eingabe-Token 2 USD und eine Million Ausgabe-Token 6 USD. Für lange Prompts nennt die Preistabelle 4 beziehungsweise 12 USD. Sie markiert die Grenze bei 200.000 Prompt-Token. Das sind nutzungsabhängige API-Preise, keine monatlichen Chat-Abos. Grok 4.6 kostet laut Preistabelle genauso viel. Die Fast-Variante kostet das Doppelte der Standardpreise, bei langen Prompts das 1,5-Fache, und ist nur in Cursor und Grok Build verfügbar, nicht über die öffentliche API.
Aus meiner Praxis
Ich nutze Grok, um auf X eine größere Leserschaft aufzubauen: für Kommentare, eigene Beiträge und das Teilen fremder Posts mit einer eigenen Einordnung. Bisher kommt oft nur ein einzelnes Like zurück. Einen überzeugenden Zuwachs an Reichweite oder Followern kann ich daraus noch nicht berichten.
Mein bisheriger Eindruck: Grok ist schnell und erzeugt gute Bilder. Das ist eine persönliche Einschätzung zur bisherigen Nutzung. Grok 4.7 habe ich noch nicht selbst getestet. Ob ein Modellwechsel meine Inhalte verbessert, bleibt offen; Themenwahl und Strategie muss ich genauso hinterfragen.
Grok 4.7 verarbeitet Text und Bilder, gibt selbst aber Text aus. Für die eigentliche Bilderzeugung dokumentiert der Anbieter separate Grok-Imagine-Modelle. Die Coding-Werte oben belegen deshalb keine bessere Bildqualität.
Für einen eigenen Vergleich würde ich denselben Bildauftrag mehrfach mit dem jeweiligen Imagine-Modell ausführen und Motivtreue, lesbare Schrift sowie die nötige Nacharbeit prüfen. Bei X-Texten wären passende Antworten und Profilbesuche näher am Ziel als ein Coding-Score. Das ist ein Vorschlag für den nächsten Test, kein bereits gemessenes Ergebnis.
Noch gut zu wissen
In der xAI-API kostet Grok 4.7 2 USD pro Million Eingabe-Token und 6 USD pro Million Ausgabe-Token. Ab 200.000 Prompt-Token gelten 4 und 12 USD. Die schnellere Variante Grok 4.7 Fast kostet das Doppelte (bei langen Prompts das 1,5-Fache) und ist nur in Cursor und Grok Build verfügbar.
Laut Anbieter ja, bei gleichem Tokenpreis: In CursorBench 4.0 steigt der Wert von 40,4 auf 46,3 Prozent, in Terminal-Bench 4.0 von 20,3 auf 37,6 Prozent (Release-Seite; die X-Grafik nennt 38,0). Das sind Herstellerwerte mit höherer Rechenstufe für 4.7, kein eigener Test.
Nein. Grok 4.7 verarbeitet Text und Bilder, gibt aber nur Text aus. Für Bilder dokumentiert der Anbieter eigene Grok-Imagine-Modelle.
Dein nächster Schritt
Vergleiche Funktionsumfang, Kosten und Grenzen anhand deiner eigenen Aufgabe. Die Profile erklären auch kostenlose Alternativen.
Vom Release zur Praxis
Schreiben mit eigener Stimme · ca. 5 Min.
Ein einfacher Schreibablauf mit KI: Fakten vorbereiten, einen Entwurf verbessern und den eigenen Ton bewahren. Inklusive kopierbarer Beispielanweisung.
Verstehen statt blind übernehmen · ca. 5 Min.
Eine Quellenangabe macht eine KI-Antwort noch nicht richtig. So prüfst du Original, Aktualität, Zusammenhang und die genaue Aussage Schritt für Schritt.
Tarife und Funktionen können sich ändern. Hier siehst du, auf welche Originalquellen sich die Angaben stützen und wann wir sie geprüft haben.